ShadowKV: Система высокопроизводительного вывода для длинного контекста LLM
«`html
ShadowKV: Система Высокой Пропускной Способности для Долгого Контекста LLM
Большие языковые модели (LLM) становятся лучше в работе с длинными контекстами. С увеличением их использования возникает необходимость в эффективной поддержке быстрого вывода. Однако, работа с длинными контекстами вызывает проблемы с кэшированием ключей и значений, что приводит к снижению производительности.
Проблемы и Решения
Существующие методы сталкиваются с тремя основными проблемами:
- потеря точности,
- недостаточное сокращение памяти,
- значительная задержка декодирования.
Стратегии удаления старых данных из кэша помогают сохранять память, но могут привести к потере точности, что особенно заметно в задачах, таких как разговоры. Решение заключается в более эффективном использовании памяти без потери скорости.
Подход ShadowKV
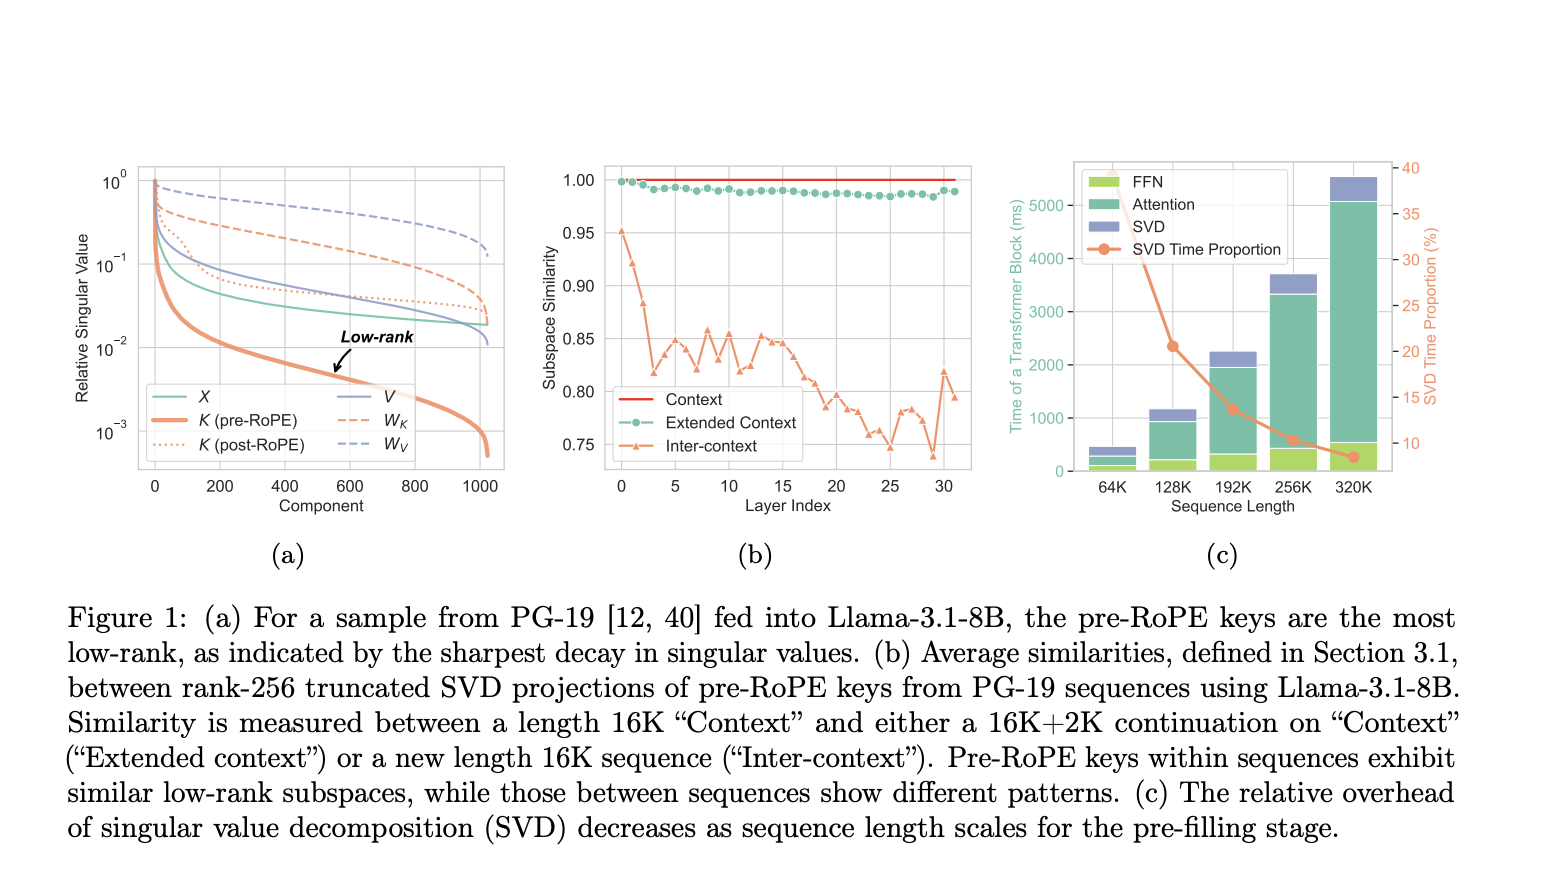
Исследователи из Carnegie Mellon University и ByteDance предложили метод ShadowKV, который хранит низкоранговый кэш ключей и выгружает кэш значений. Это позволяет уменьшить использование памяти и повысить скорость обработки. ShadowKV использует точные методы выбора пар ключ-значение и создает только необходимые разреженные пары по мере необходимости.
Этапы Работы ShadowKV
Алгоритм ShadowKV делится на два основных этапа: предварительное заполнение и декодирование. На этапе предварительного заполнения происходит сжатие кэша ключей и выгрузка кэша значений в память ЦП, что значительно ускоряет обработку данных.
Преимущества ShadowKV
Метод позволяет обрабатывать больший объем данных с меньшими задержками и повышает скорость обработки при сохранении точности. ShadowKV может поддерживать до 6 раз большие объёмы пакетов, что превосходит возможности безграничного размера пакета.
Как ИИ Может Ускорить Развитие Вашей Компании
Если вы хотите, чтобы ваша компания развивалась с помощью искусственного интеллекта, используйте ShadowKV для оптимизации процессов.
Практические Рекомендации
- Анализируйте, как ИИ может изменить вашу работу.
- Определите, какие ключевые показатели эффективности нужно улучшить с помощью ИИ.
- Подберите подходящее решение и внедряйте его постепенно.
- Если нужны советы по внедрению ИИ, пишите нам.
Попробуйте AI Sales Bot
Это AI ассистент для продаж, который помогает отвечать на вопросы клиентов и генерировать контент для отдела продаж.
Узнайте, как ИИ может изменить процесс продаж в вашей компании с решением от saile.ru!
«`