BEAL: Байесовский метод активного обучения для эффективной многометочной классификации текста
«`html
Многоуровневая классификация текста (MLTC)
Многоуровневая классификация текста (MLTC) назначает несколько соответствующих меток тексту. Хотя глубокие модели обучения достигли отличных результатов в этой области, они требуют больших объемов размеченных данных, что дорого и занимает много времени.
Решение через активное обучение
Активное обучение помогает оптимизировать этот процесс, выбирая наиболее информативные неразмеченные образцы для аннотации, что снижает затраты на разметку. Однако большинство существующих методов активного обучения разработаны для традиционных однолейбловых моделей и не применимы к глубоким многометочным моделям.
Метод BEAL
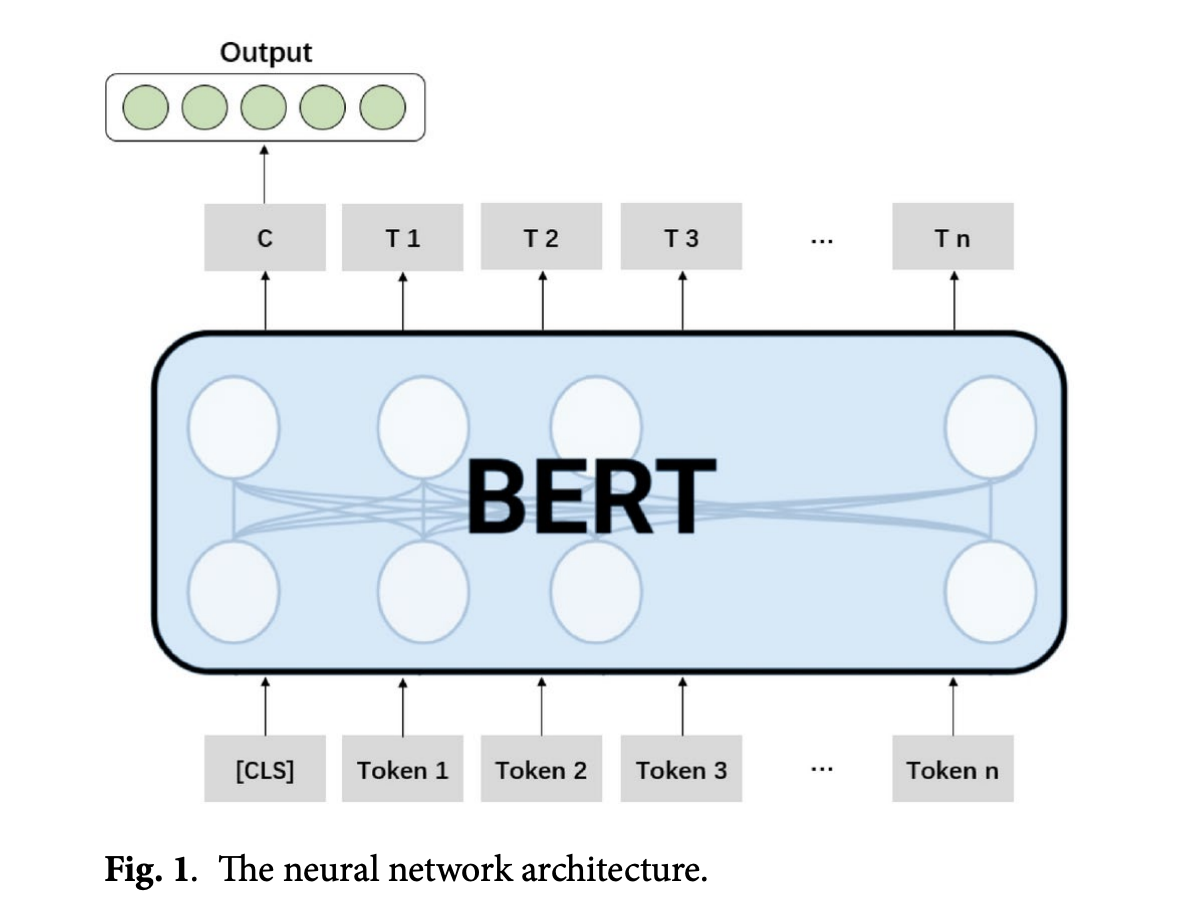
Исследователи из Института автоматизации Китайской академии наук и других учреждений предложили метод BEAL, который использует байесовское глубокое обучение для многометочной классификации текста. Этот метод улучшает эффективность обучения, достигая сходимости с меньшим количеством размеченных образцов.
Преимущества метода
- Снижение требований к размеченным данным по сравнению с существующими методами.
- Выбор образцов с наименьшей ожидаемой уверенностью для разметки, что повышает эффективность модели.
- Применение метода к другим задачам многометочной классификации.
Проверка метода BEAL
Авторы провели оценку метода BEAL на двух эталонных наборах данных: AAPD и StackOverflow. Результаты показали, что BEAL превосходит другие методы, требуя всего 64% размеченных образцов на AAPD и 40% на StackOverflow.
Заключение
Метод BEAL представляет собой активное обучение для глубоких моделей MLTC, позволяя более эффективно обучать модели с меньшим количеством размеченных образцов. Это особенно ценно в реальных приложениях, где получение больших объемов размеченных данных затруднительно.
Как внедрить ИИ в вашу компанию
Если вы хотите, чтобы ваша компания развивалась с помощью искусственного интеллекта (ИИ), следуйте этим шагам:
- Проанализируйте, как ИИ может изменить вашу работу.
- Определите ключевые показатели эффективности (KPI), которые хотите улучшить с помощью ИИ.
- Выберите подходящее решение и внедряйте его постепенно.
- Начните с малого проекта, анализируйте результаты и KPI.
- На основе полученных данных расширяйте автоматизацию.
Получите советы по внедрению ИИ
Если вам нужны советы по внедрению ИИ, пишите нам.
Узнайте, как ИИ может изменить процесс продаж
Это AI ассистент для продаж, который помогает отвечать на вопросы клиентов и генерировать контент для отдела продаж. Будущее уже здесь!
«`