Использование языковых моделей для автоматического формирования вознаграждения в обучении с подкреплением.
Решение проблемы назначения кредитов с помощью языковых моделей для автоматизации формирования вознаграждений в обучении с подкреплением
Проблема:
Одной из ключевых проблем в обучении с подкреплением (RL) является назначение кредита за принятие решений. Необходимо определить, какие действия привели к желаемому результату, особенно когда обратная связь ограничена или задержана.
Решение:
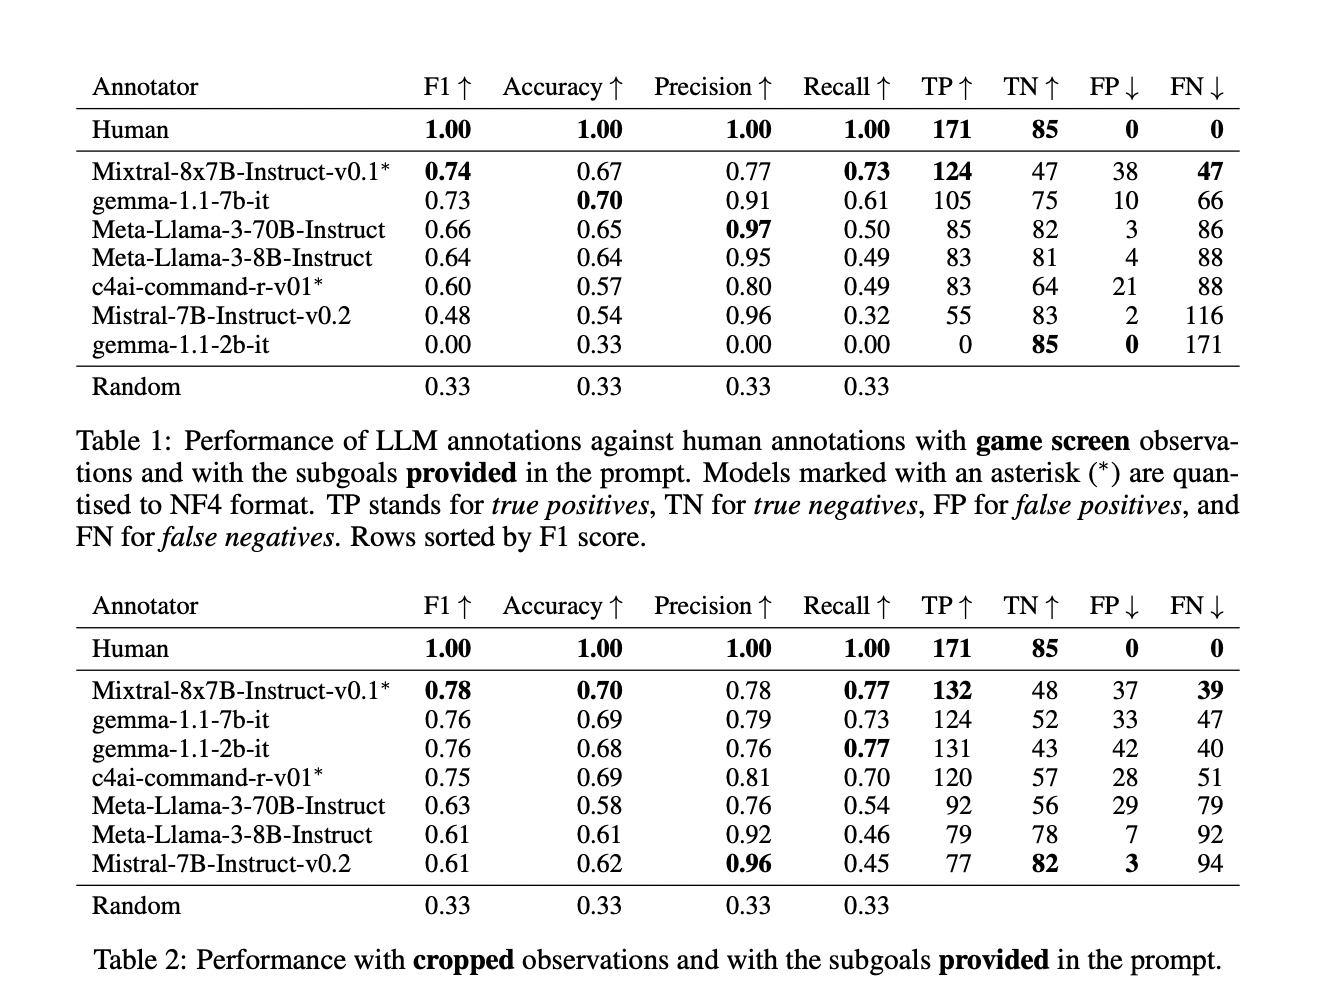
Подход CALM позволяет автоматизировать процесс назначения кредитов с помощью языковых моделей. Он декомпозирует задачи на подцели и оценивает прогресс агента к их достижению, обеспечивая вспомогательные сигналы вознаграждения.
Преимущества:
Использование LLM позволяет сократить участие человека в проектировании систем RL, повышая их эффективность в средах с ограниченными или задержанными наградами. Это снижает необходимость вручную создаваемых функций вознаграждения, обеспечивая более точное формирование поведения агента.