Ученые Стэнфордского университета предлагают новое улучшение для Vision Transformers.
«`html
Модели «Зрение-Язык» и их проблемы
Модели «Зрение-Язык» (VLMs) сталкиваются с трудностями в задачах пространственного мышления, таких как локализация объектов, подсчет и ответ на реляционные вопросы. Это связано с тем, что трансформеры зрения (ViTs), обученные на уровне изображений, неэффективно кодируют локализованную информацию, что ограничивает пространственное понимание.
Новое решение от Стэнфордского университета
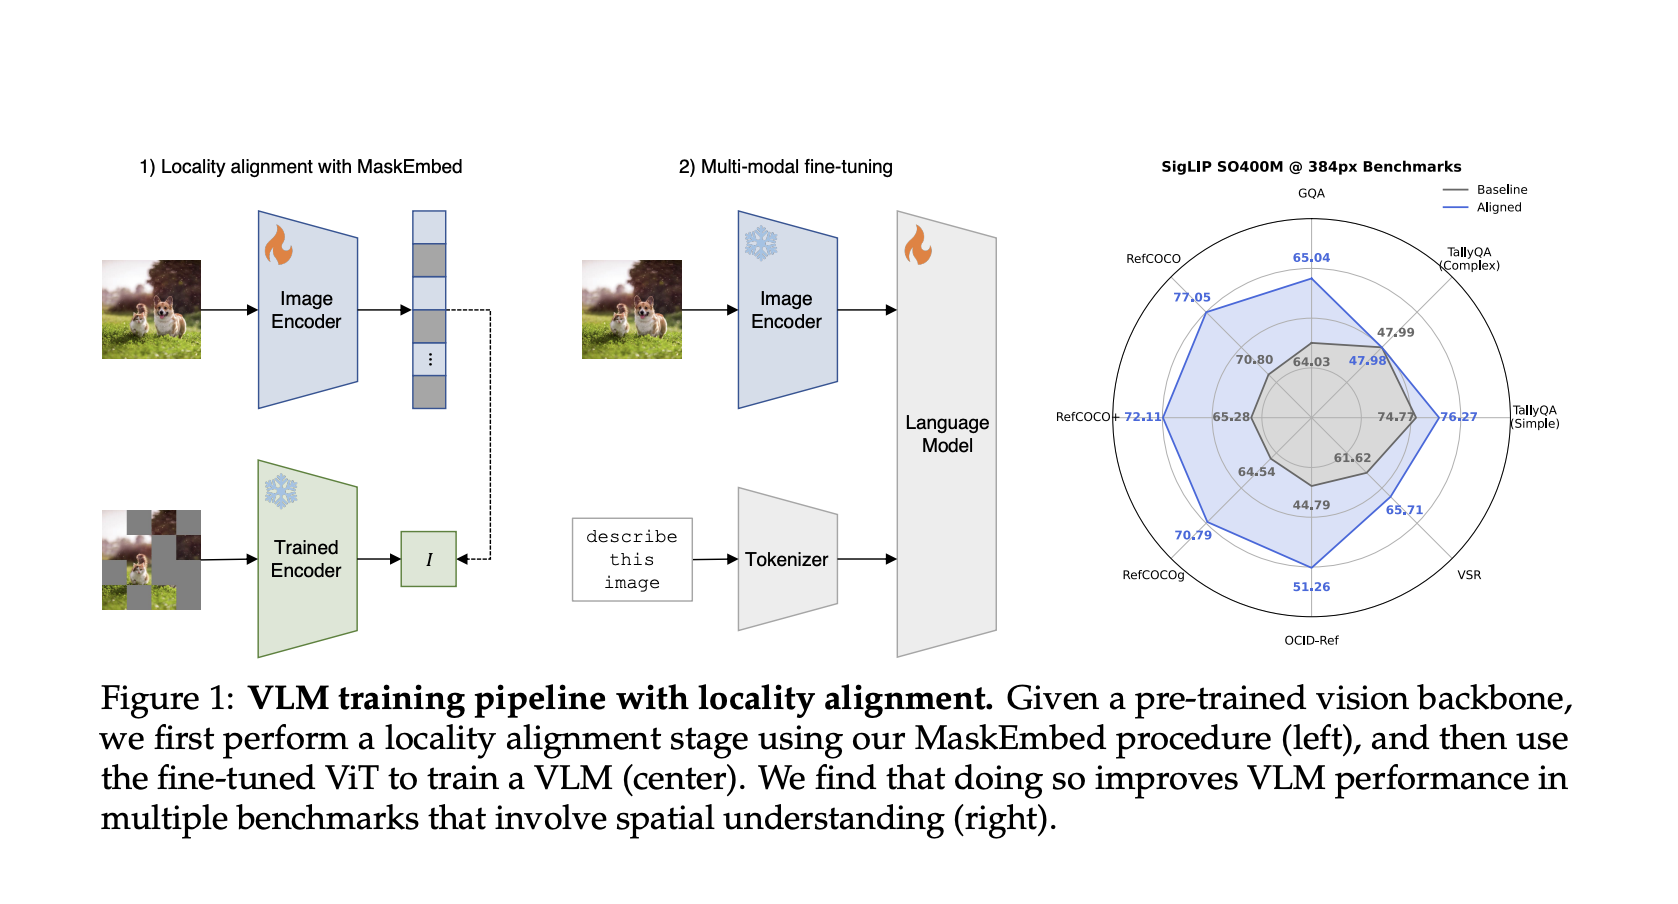
Исследователи из Стэнфорда предлагают новое решение под названием «Локальная выравнивание». Это этап после обучения для трансформеров зрения, который улучшает способности локальной семантики ViTs для повышения их производительности в задачах пространственного мышления.
Процесс MaskEmbed
Их метод включает процедуру дообучения под названием MaskEmbed, которая использует потерю реконструкции с маской для изучения семантических вкладов каждого фрагмента изображения. Это позволяет модели понять, как каждый участок изображения влияет на общее представление.
Преимущества локального выравнивания
- Не требует новых размеченных данных.
- Эффективен и прост в реализации.
- Снижает вычислительные затраты по сравнению с традиционными подходами.
Результаты и эффективность
Эффективность локального выравнивания была протестирована на различных бенчмарках. Модели ViTs с локальным выравниванием показали улучшенные результаты в задачах семантической сегментации и пространственного понимания.
Улучшение производительности
Конкретно, улучшения были замечены в задачах, таких как локализация объектов, реляционное вопросно-ответное взаимодействие и подсчет. Локальное выравнивание улучшает извлечение локальной семантики без ущерба для глобального понимания изображения.
Как использовать ИИ для вашего бизнеса
Если вы хотите, чтобы ваша компания развивалась с помощью искусственного интеллекта (ИИ), следуйте этим шагам:
- Проанализируйте, как ИИ может изменить вашу работу.
- Определите области для автоматизации.
- Установите ключевые показатели эффективности (KPI).
- Выберите подходящее ИИ-решение и внедряйте его постепенно.
- Расширяйте автоматизацию на основе полученных данных.
Получите помощь и советы
Если вам нужны советы по внедрению ИИ, пишите нам в Телеграм.
Попробуйте AI Sales Bot
Это AI ассистент для продаж, который помогает отвечать на вопросы клиентов и генерировать контент для отдела продаж.
Будущее уже здесь!
Узнайте, как ИИ может изменить процесс продаж в вашей компании с помощью современных решений.
«`