Улучшение больших языковых моделей с помощью разнообразных инструкций: подход с кластеризацией и итеративным усовершенствованием.
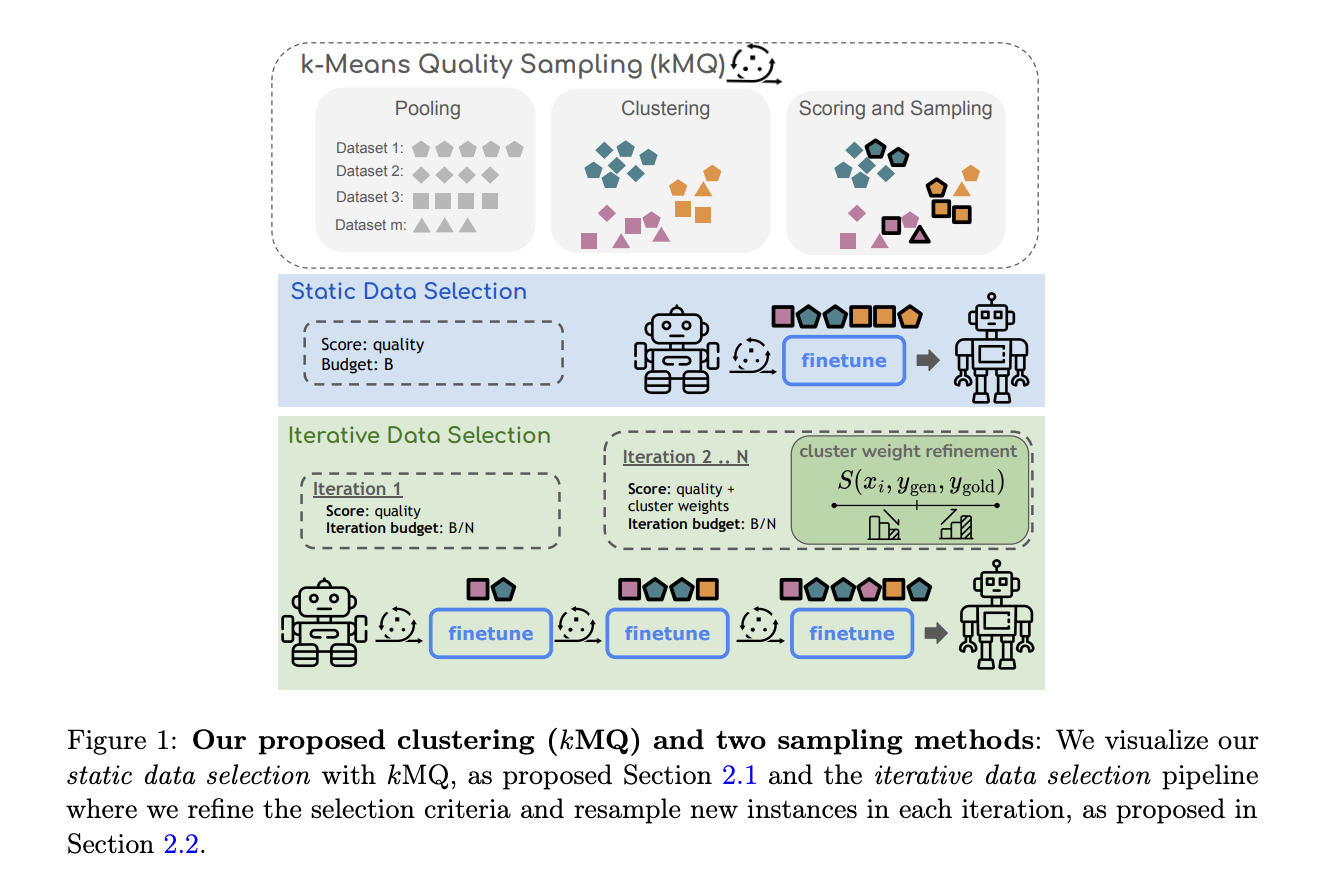
Улучшение больших языковых моделей с разнообразными данными обучения: подход к кластеризации и итеративному совершенствованию
Значение разнообразных данных для обучения моделей
Большие языковые модели (LLM) стали ключевой частью искусственного интеллекта, позволяя системам понимать, генерировать и отвечать на человеческий язык. Эти модели используются в различных областях, включая естественное языковое мышление, генерацию кода и решение проблем. Однако для того, чтобы модели были более специфичными для задач и соответствовали человеческому намерению, требуется их дополнительная настройка.
Баланс качества и разнообразия данных
Текущие методы выбора данных обычно сосредотачиваются на локальных характеристиках, таких как качество данных. Однако важно не только удалять низкокачественные образцы или дубликаты, но также обеспечить баланс между качеством и разнообразием. Приоритет разнообразия в обучающих данных позволяет модели эффективно обобщать результаты на различные задачи, предотвращая переобучение на конкретные области.
Инновационный метод выбора данных и кластеризации
Исследователи из Норт-Вестернского университета, Стэнфордского университета, Google Research и Cohere For AI предложили инновационный метод итерационного совершенствования для преодоления вызовов в выборе данных. Их подход подчеркивает выбор данных, сосредотачивающийся на разнообразии, используя кластеризацию k-средних. Этот метод гарантирует, что выбранный набор данных точнее представляет весь набор данных.
В заключение, исследователи разработали эффективный метод, который сбалансированно учитывает разнообразие и качество в выборе данных. Данный подход приводит к улучшению производительности до 7% и обеспечивает возможность обобщения моделей на широком спектре задач.
Если ваша компания хочет оставаться конкурентоспособной с помощью искусственного интеллекта, обратитесь к методу улучшения больших языковых моделей с разнообразными данными обучения.
**Проверьте статью и репозиторий на GitHub. Вся заслуга за это исследование принадлежит его авторам.**