Модель для обработки визуальных данных различной детализации
«`html
MG-LLaVA: Инновационная многомодальная модель для обработки визуальных данных различной четкости
Расширение границ возможностей
Multi-modal Large Language Models (MLLMs) имеют различные приложения в визуальных задачах. Они опираются на визуальные особенности, извлеченные из изображения, чтобы понять его содержимое. Когда на вход подается изображение низкого разрешения с меньшим количеством пикселей, моделям передается меньше информации для работы. Из-за этого ограничения такие модели часто должны быть более точными в идентификации объектов, сцен или действий на изображении. Это поведение MLLMs влияет на их эффективность в визуальных задачах.
Исследователи из Университета Шанхайского Жаотун и Лаборатории искусственного интеллекта в Шанхае, а также S-Lab Университета Наньянской технологии представили новую модель MLLM, MG-LLaVA, чтобы преодолеть ограничения текущих моделей MLLM при обработке изображений низкого разрешения. Основная задача заключается в улучшении этих моделей для захвата и использования высокоразрешенных и объектно-центричных особенностей для улучшенного визуального восприятия и понимания.
Текущие MLLMs обычно используют предварительно обученные большие языковые модели (LLMs) для обработки объединенных визуальных и языковых эмбеддингов, принимая на вход низкоразрешенные изображения, такие как модели LLaVA. Хотя эти модели показали свою перспективность, они опираются на входы низкого разрешения, что ограничивает их способность обрабатывать мелкие детали и распознавать маленькие объекты на сложных изображениях. Исследователи предложили различные улучшения, включая обучение на разнообразных наборах данных, использование изображений высокого разрешения и применение динамических соотношений сторон. Однако для реализации этих подходов часто необходимо интегрировать объектные особенности и многограные входы, что критично для полного визуального понимания.
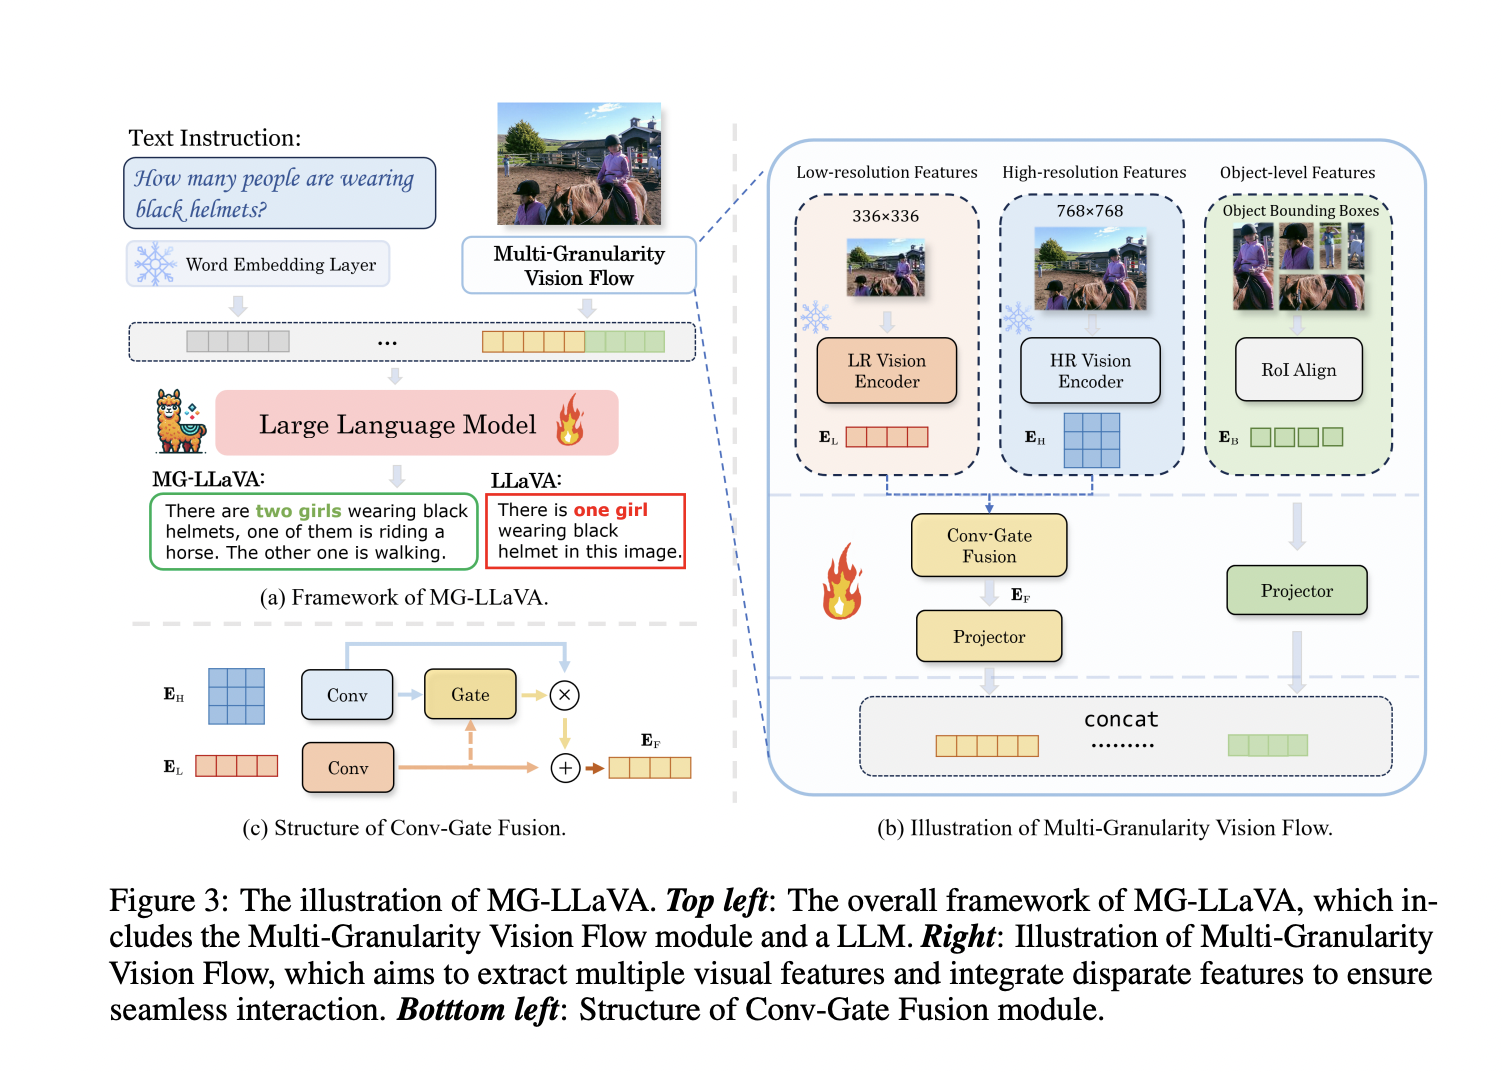
Предложенная модель MG-LLaVA является инновационной MLLM, которая значительно улучшает визуальную обработку за счет использования многограного потока видения. Это включает в себя низкоразрешенные, высокоразрешенные и объектно-центричные особенности, улучшая способность модели захватывать мелкие детали и улучшать распознавание объектов. Архитектура MG-LLaVA основана на архитектуре LLaVA, которая интегрирует высокоразрешенный визуальный кодер, сеть для интеграции особенностей Conv-Gate и объектные особенности, выведенные из ограничивающих рамок, выявленных детекторами с открытым словарем.
Архитектура MG-LLaVA состоит из двух основных компонентов: многограная архитектура потока видения и большая языковая модель. Архитектура потока видения обрабатывает изображения различного разрешения с использованием предварительно обученного Vision Transformer (ViT) для низкоразрешенных и ConvNeXt для высокоразрешенных особенностей. Для эффективного слияния этих особенностей сеть для интеграции особенностей Conv-Gate выравнивает ширину каналов особенностей и модулирует семантическую информацию, поддерживая вычислительную эффективность.
Объектные особенности интегрируются с использованием выравнивания области интересов (RoI) для извлечения детальных особенностей из выявленных ограничивающих рамок, которые затем конкатенируются с другими визуальными токенами. Этот многогранный подход улучшает способность модели захватывать полную визуальную информацию и интегрировать ее с текстовыми эмбеддингами. MG-LLaVA обучается на общедоступных мультимодальных данных и дообучается на данных визуальной инструкции.
Обширные оценки на нескольких бенчмарках, включая MMBench и SEEDBench, демонстрируют, что MG-LLaVA превосходит существующие MLLMs сравнимого размера параметров. Модель значительно улучшает восприятие и визуальное понимание, превосходя модели, такие как GPT-4V и GeminiPro-V. Исследование также включает комплексные эксперименты, подтверждающие эффективность объектных особенностей и сети для интеграции особенностей Conv-Gate.
В заключение, MG-LLaVA преодолевает ограничения текущих MLLMs путем внедрения многограного потока видения, который эффективно обрабатывает низкоразрешенные, высокоразрешенные и объектно-центричные особенности. Этот инновационный подход значительно улучшает визуальное восприятие и способность понимания модели, демонстрируя превосходную производительность на различных мультимодальных бенчмарках.
Прочитайте статью и проект. Вся заслуга за это исследование принадлежит его проводившим исследования проекта. Также не забудьте подписаться на нас в Twitter.
Присоединяйтесь к нам в Telegram-канале и группе LinkedIn.
Если вам понравилась наша работа, вам понравится наш новостной бюллетень.
Не забудьте присоединиться к нашему сабреддиту по ИИ.
Источник: MarkTechPost